
業務データ、リアルタイム分析、AIワークロード——これまでバラバラだったものをひとつのデータベースに。OceanBase AI Database 詳細はこちら ->
業務データ、リアルタイム分析、AIワークロード——これまでバラバラだったものをひとつのデータベースに。OceanBase AI Database 詳細はこちら -> ->
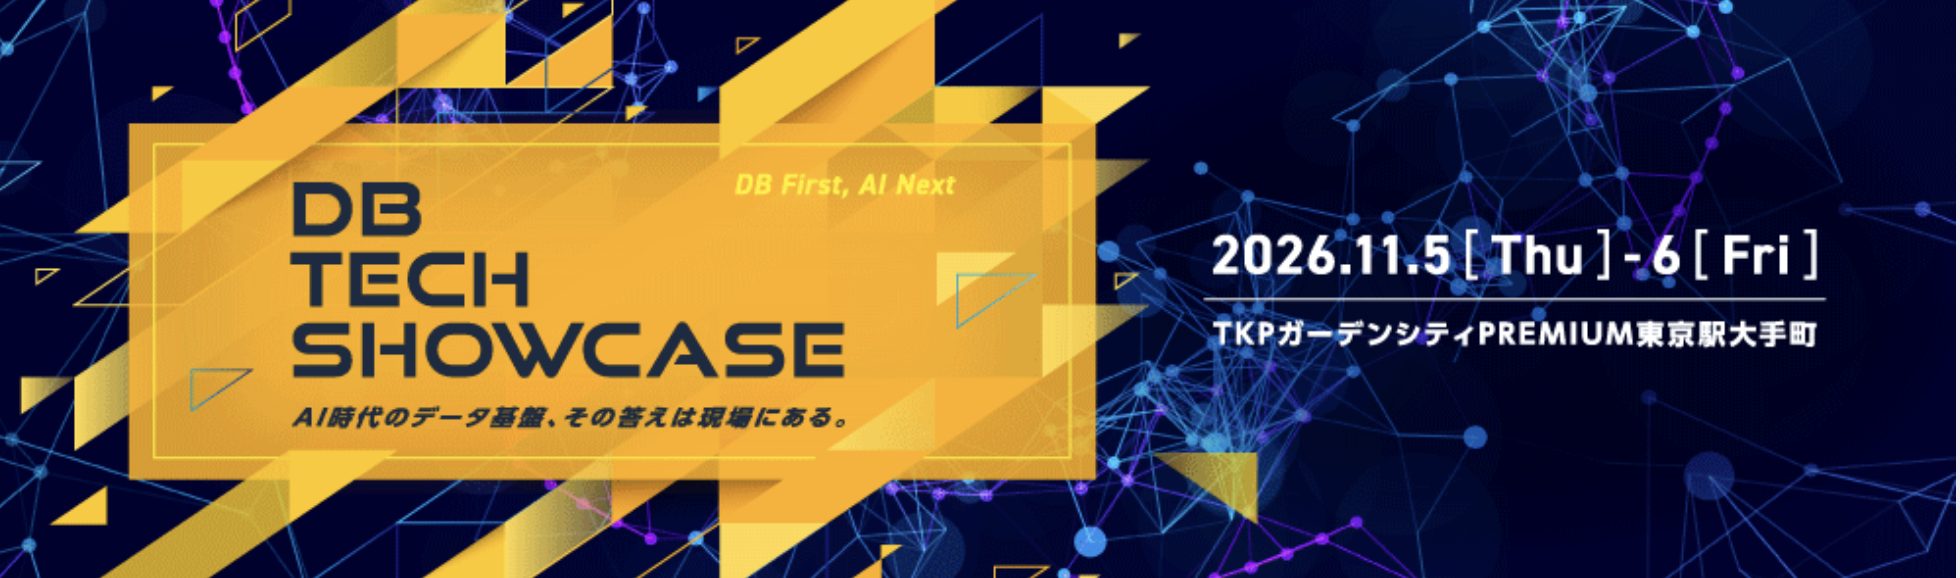
『db tech showcase 2026 Tokyo』OceanBase セッション登壇 & ブース出展決定!
OceanBase Japan(以下「OceanBase」)は、2026年11月5日(木)~6日(金)の2日間にわたり開催される、国内最大級のデータベースカンファレンス「db tech showcase 2026 Tokyo」に協賛し、2つのスペシャルセッションに登壇いたします。
本カンファレンスは、DBエンジニア、データサイエンティスト、ITリーダーが一堂に会する国内最大級の技術イベントです。AI時代のデータ基盤のあり方や、クラウド時代のDB選定など、現場の最新知見を学べるセッションをお届けします。
開催概要
項目 | 内容 |
|---|---|
| イベント名称 | db tech showcase 2026 Tokyo |
| 日時 | 2026年11月5日 (木) 〜 6日 (金) |
| 会場 | TKPガーデンシティPREMIUM 東京駅大手町 |
| 主催 | 株式会社インサイトテクノロジー |
| 参加費 | 無料 (事前登録制) |
| 公式サイト | https://www.db-tech-showcase.com/2026/ |
登壇セッション概要
OceanBaseからは、AI時代の次世代統合データ基盤に関する技術セッションと、株式会社f4samurai様をゲストにお迎えしたリアルなDB移行事例セッションの計2セッションをお届けします。
セッション ①
セッション名:性能・コスパで一度NewSQLに幻滅し、AWS回帰を検討したf4samuraiが、それでもOceanBaseを選んだ理由 〜シャーディング地獄から始まった、分散DB選定と運用のリアル〜
- 日時:2026年11月5日 (木) 13:40 - 14:20 / Room D
- 会場:Room D
- スピーカー:f4samurai 酒井 クラウドエンジニア & OceanBase 吉田 ソリューションアーキテクト
セッション内容
クラウドネイティブ化やサービスの大規模化に伴い、データベースには高可用性、スケーラビリティ、運用負荷の軽減、コスト効率が求められています。本セッションでは、NewSQLの一つであるOceanBaseのアーキテクチャと、4つの価値「高可用性・柔軟な拡張性・シンプルな運用・高いコスト効率」を解説します。Paxosによる強整合性、RPO=0、RTO<8秒(8秒以内で自動フェイルオーバー)、シャーディングに依存しないオンラインスケール、MySQL互換、論理的なリソース分離を実現するマルチテナント、ストレージ圧縮などの技術もご紹介します。
メインとなるのは、日本初のOceanBase商用事例となった株式会社f4samurai様のDB選定・移行のストーリーです。シャーディングによる運用負荷からの脱却を目指し、NewSQLを採用したものの、実際の運用では性能やコストの面で新たな課題に直面。一度はAWSへの回帰を検討するまでに至りました。そこから、なぜ再びNewSQLという選択肢に目を向け、最終的にOceanBaseを選んだのか。
本セッションでは、f4samurai様のNewSQL間移行プロジェクトをもとに、DB選定の判断基準、事前検証、移行時に直面した互換性や運用上の課題、そしてOceanBaseへの移行によって何が変わったのかを掘り下げます。「脱シャーディング」の先に何が待っているのか。一度NewSQLを使い、AWS回帰まで検討したユーザーだからこそ語れる、分散DB選定と運用のリアルをお届けします。
セッション ②
セッション名:AI時代、分散型データベースはどう進化するのか? 〜OLTP・OLAP・AIワークロードを単一エンジンで処理するOceanBase Lakebase〜
- 日時:2026年11月5日 (金) 14:30 - 15:10
- 会場:Room A
- スピーカー:吉田 ソリューションアーキテクト
セッション内容
AI時代において、データベースには従来のトランザクション処理だけでなく、リアルタイム分析、全文検索、ベクトル検索、マルチモーダルデータ処理など、より多様なワークロードへの対応が求められています。しかし、これらを個別のデータベースやサービスで構築すると、データの分断やETLによる複雑な連携、運用負荷、コスト増大といった新たな課題が生じます。
本セッションでは、分散データベースとしてOceanBaseがAI時代の統合データ基盤へどのように進化しているのかを具体的なユースケースを交えて解説します。OLTP・OLAPに加え、Vector Search、Full-text Search、マルチモーダルデータを一つのデータ基盤で扱う「One Data Foundation」、エージェントフレンドリーの考え方と、その実現を支えるOceanBaseの最新技術、プロダクトラインアップをご紹介します。
🎁 セッション参加特典
セッションにご参加いただき、アンケートにお答えいただいた方、およびOceanBase展示ブースへお越しいただいた方を対象に、豪華ノベルティ・プレゼント企画を実施いたします!
- 【セッション参加者限定】抽選でオリジナルノベルティ&アマゾンギフトカード!
- 本セッションに参加しアンケートにご回答いただいた方の中から抽選で、OceanBase特製グッズやアマゾンギフトカードをプレゼントいたします。
事前参加登録
本イベントへのご参加には、db tech showcase 2026 Tokyo 公式サイトからの事前登録(無料)が必要です。
[ 事前登録はこちら https://www.db-tech-showcase.com/2026/ ]
皆様のご参加を心よりお待ちしております。


分散データベース運用でOceanBaseが複雑さを抑えられる理由
1. データベースのインスタンスが増えると、運用はどう変わるのか 事業が成長し、マイクロサービスの導入が進むと、注文、ユーザー、在庫、レポートなどのサービスごとに、独立したデータベースが必要になることがあります。開発、テスト、ステージング、本番の各環境に加え、顧客やチャネルごとにデータを分離する必要も出てきます。その結果、わずか1〜2年で、インスタンス数が十数個から100を超える規模に増えることもあります。これらを個別に管理していると、監視、変更作業、原因調査、復旧にかかる負担も増していきます。 アラートが増え、重要な問題を見つけにくくなる。100個のインスタンスで監視システム、アラートルール...

LangChainからCursorまで、AI開発のデータ基盤をOceanBaseに集約する
AIアプリ開発でデータ層が分散しやすくなる理由 RAGやAIエージェントを組み込んだアプリケーションを作ると、使うツールは自然と増えていきます。LangChainやLlamaIndexで処理フローを組み立て、OpenAIやローカルモデルで推論を行い、Difyのようなワークフロープラットフォームで業務ロジックをつなぎ、Cursor、Cline、Claude CodeなどのIDEで実装を進める。最近のAI開発では、こうした構成は珍しくありません。 一方で、ツールが増えるほどデータ層は複雑になりがちです。業務データはRDB、ベクトル検索は専用Vector DB、キーワード検索は検索エンジン、エージェ...
OceanBaseのAI Function入門。SQLでここまでできる
OceanBaseには、`AI_COMPLETE`、`AI_EMBED`、`AI_RERANK`、`AI_PROMPT`、`AI_SPLIT_DOCUMENT` という5つのSQL組み込み関数があります。これらを使うと、テキストのチャンキング、ベクトル化、検索結果の再ランキング、テキスト生成といった処理をデータベースの中で扱えます。ベクトル検索やハイブリッド検索と同じエンジン上で動くので、RAGの一連の流れをSQLでそのままつなげて書けます。 OceanBaseでは、LLMの機能をデータベース関数として利用できます。使い方は`UPPER()`や`SUM()`に近く、モデルのエンドポイントを登録...